
言語メディア学研究室
人間の脳や視線データとAIの「頭の中」を比較し、安全性を高める研究
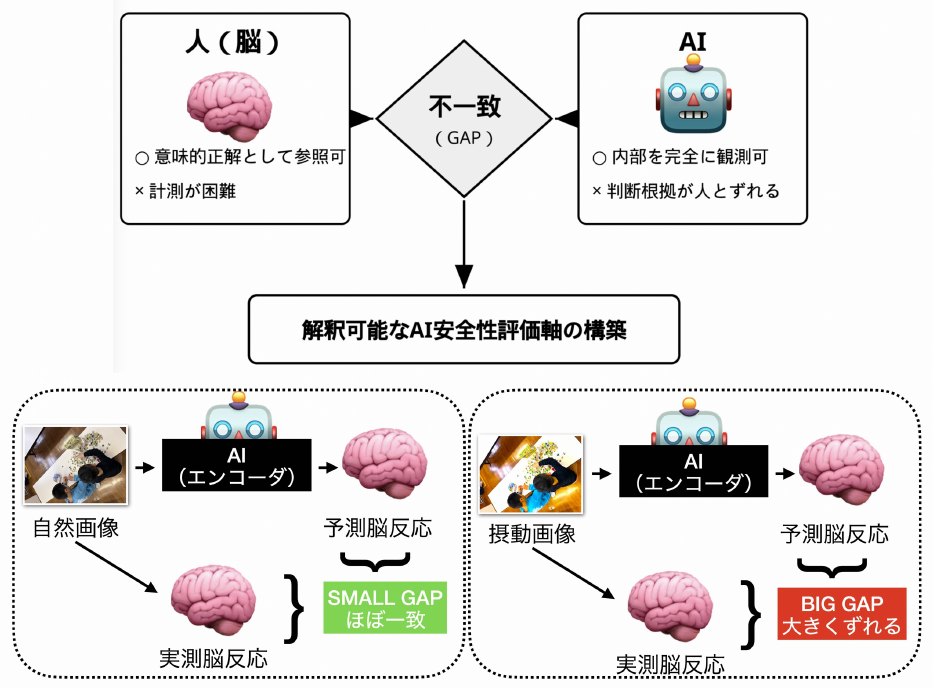
AIが危険な行動と安全な行動をどのように区別しているのか、その内部の情報処理を調べています。LLMの内部表現を可視化するLogit Lensや、人間の脳活動・視線とAIの内部表現を比較する方法を用いて、AIが判断する仕組みを探ります。ブラックボックスになりがちな生成AIをより理解可能にし、現実世界で安全に使える新しいAIの実現へのヒントを得るため、認知科学や哲学など異分野の研究者とも共同研究しています。